خلاصه در یک نگاه
- ربات هوش مصنوعی NLP سه سطح دارد: منوی قاعده مند، تشخیص قصد و پاسخ مولد بر پایه داده شما. هر سطح، هزینه و ریسک خودش را دارد.
- روش پایه پاسخ گویی هوشمند، بازیابی داده و تولید پاسخ بر پایه آن (RAG) است. بر پایه گزارش های صنعتی، این روش می تواند خطای ساختگی را حدود ۴۰ تا ۷۱ درصد کم کند.
- کیفیت پاسخ به مدل انتخابی وابسته نیست؛ به کیفیت منبع داده، تکه بندی درست و دستور سیستم بستگی دارد.
- باید به مدل یاد بدهید «نمی دانم» بگوید و در همان نقطه، کار به اپراتور انسانی منتقل شود.
- بدون مجموعه آزمون و بازبینی هفتگی، هوشمندتر شدن ربات قابل سنجش نیست و بهبود به حدس تبدیل می شود.
ربات قاعده مند در برابر پرسش پیش بینی شده خوب کار می کند و در برابر پرسش با جمله بندی جدید، متوقف می شود. اینجا نقطه ای است که کسب و کارها سراغ هوش مصنوعی می روند: نه برای اینکه ربات «باهوش» به نظر برسد، بلکه برای اینکه جمله بندی کاربر را بفهمد و از اسناد خود شما پاسخ بدهد.
در این مقاله سه سطح هوشمندی، سازوکار بازیابی و تولید پاسخ، پنج عاملی که کیفیت پاسخ را تعیین می کند، مدیریت هزینه و روش سنجش پیشرفت را می بینیم. اگر ربات پایه شما ساخته شده و می خواهید لایه هوشمند به آن اضافه کنید، معماری پیشنهادی در طراحی ربات تلگرام اختصاصی توضیح داده شده است.
سه سطح هوشمندی ربات
پیش از انتخاب مدل، سطح را انتخاب کنید. سه سطح عملی وجود دارد:
| سطح | روش | مناسب برای |
|---|---|---|
| سطح ۱: قاعده مند | منو، دکمه و تطبیق کلیدواژه | پرسش های محدود و مشخص، مثل ساعات کاری و پیگیری سفارش |
| سطح ۲: تشخیص قصد | دسته بندی پرسش کاربر و هدایت به پاسخ آماده | دامنه متوسط با چند دسته پرسش تکراری |
| سطح ۳: پاسخ مولد | بازیابی از پایگاه دانش و تولید پاسخ با مدل زبانی | پرسش های متنوع با جمله بندی آزاد |
اشتباه رایج، شروع از سطح سه برای همه نیازها است. سطح سه هزینه و ریسک بیشتری دارد و در غالب موارد، ترکیب سطح دو و سه بهترین نتیجه را می دهد: پرسش های تکراری با سطح دو سریع و ارزان پاسخ داده می شوند و پرسش های آزاد به سطح سه می روند.
بازیابی و تولید پاسخ: سازوکار RAG
سازوکار بازیابی داده در عمل
منطق کار ساده است: پرسش کاربر به بردار تبدیل می شود، مرتبط ترین بخش های پایگاه دانش شما پیدا می شوند، همان بخش ها به مدل داده می شود و مدل فقط بر پایه آن ها پاسخ می نویسد. مزیت این روش، جلوگیری از پاسخ ساختگی است، اما معجزه نمی کند.
گزارش های صنعتی نشان می دهد همین روش به تنهایی می تواند خطای پاسخ ساختگی را حدود ۴۰ تا ۷۱ درصد کم کند و با افزودن لایه های بازبینی و کنترل، نتیجه بهتر هم می شود. در کاربرد پشتیبانی، گزارش ها از حل خودکار بخش بزرگی از تیکت ها (تا حدود ۷۰ درصد در سناریوهای خوش تعریف) خبر می دهند، اما این عدد به کیفیت پایگاه دانش شما وابسته است، نه به مدل.
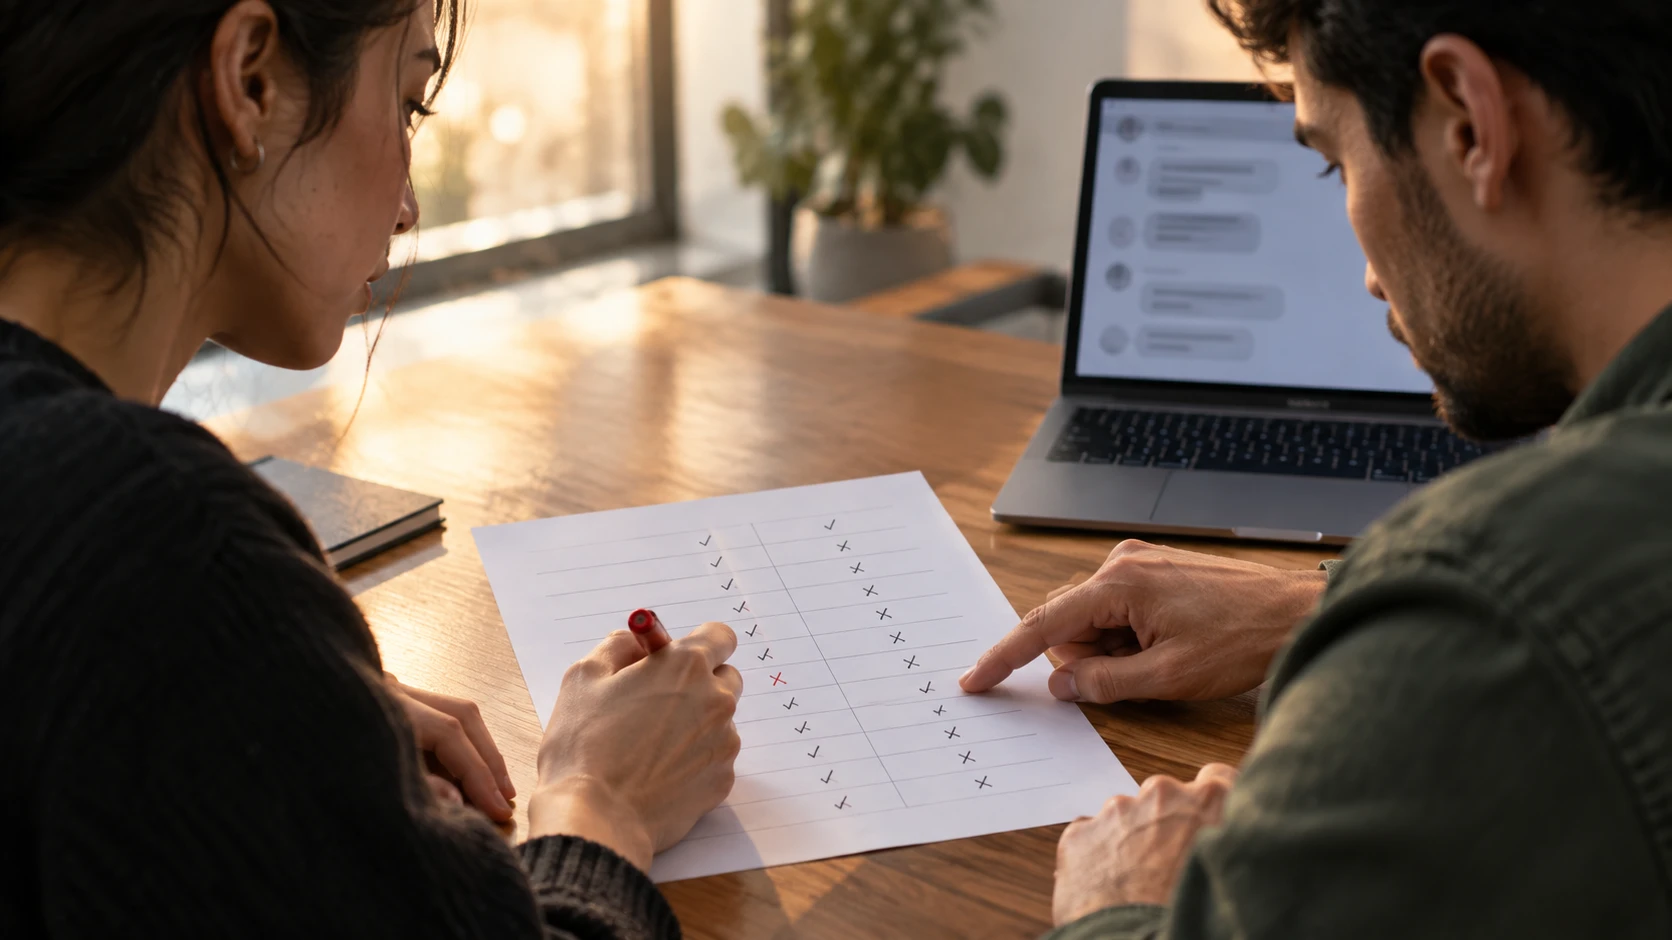
اثر بازیابی داده روی کیفیت، عددی هم هست: کاهش پاسخ ساختگی با بازیابی داده در گزارش های صنعتی حدود ۴۰ تا ۷۱ درصد ثبت شده است (گزارش کنترل خطا در RAG) و در سناریوهای خوش تعریف پشتیبانی، تا حدود ۷۰ درصد تیکت ها بدون انسان حل شده است (گزارش پشتیبانی ۲۰۲۶). همین دو عدد نشان می دهد چرا کیفیت پایگاه دانش از انتخاب مدل مهم تر است.
پنج عواملی که کیفیت پاسخ را تعیین می کند
- کیفیت منبع داده: پاسخ روی محتوای قدیمی یا متناقض، همیشه بد است. پیش از هر کار فنی، اسناد را پاکسازی و یکسان سازی کنید. توصیه های عملی برای کاهش پاسخ ساختگی در راهنمای کاهش خطای مدل آمده است.
- تکه بندی درست: متن باید به بخش های کوتاه و مستقل معنا شکسته شود. تکه های خیلی بزرگ، پاسخ های بی ربط تولید می کنند و تکه های خیلی کوچک، موضوع را از دست می دهند.
- دستور سیستم: لحن، محدوده و ممنوعیت های ربات در همان دستور تعریف می شود؛ مثل «فقط از متن زیر پاسخ بده» و «وعده تخفیف نده».
- صداقت مدل: باید صریح به مدل گفت وقتی پاسخ در منابع نبود، بگوید نمی دانم و کار را به انسان منتقل کند.
- لایه بازبینی: بازبینی خودکار پاسخ در مواردی مثل قیمت، تعهد و اطلاعات حساس، پیش از ارسال به کاربر.
سه عامل با بیشترین اثر
نکته عملی: از این پنج مورد، سه مورد اول بیشترین اثر را دارند و ربطی به انتخاب مدل ندارند. پروژه هایی که روی داده و تکه بندی وقت می گذارند، با مدل ارزان تر هم نتیجه بهتری می گیرند.
پنج اقدام عملی که خطای پاسخ را کم می کند: پاکسازی داده، تکه بندی هوشمند، مهندسی دستور، آموزش پاسخ «نمی دانم» و افزودن لایه بازبینی (پنج عامل کیفیت پاسخ). الزامات پایگاه دانش را هم دست کم نگیرید؛ منابع تازه، سطوح دسترسی، آزمون و انتقال به انسان بخشی از حاکمیت داده است (الزامات پایگاه دانش).
هزینه را چطور کنترل کنیم
هزینه پاسخ گویی هوشمند، بر پایه حجم متن ورودی و خروجی محاسبه می شود. سه اقدام عملی، هزینه را به شکل محسوس پایین می آورد:
- مسیرسازی ارزان: تشخیص قصد و دسته بندی پرسش با مدل کوچک و ارزان انجام شود و فقط پرسش های واقعا نیازمند پاسخ مولد به مدل بزرگ بروند.
- محدود کردن حافظه گفت و گو: لازم نیست کل تاریخچه گفت و گو به مدل داده شود؛ خلاصه چند پیام آخر کافی است.
- ذخیره پاسخ های پرتکرار: پرسش های تکراری را می توان با پاسخ تایید شده و بدون فراخوانی مدل جواب داد.
این سه اقدام، هم هزینه را کنترل می کند و هم زمان پاسخ را کوتاه تر می کند. هزینه ماهانه مدل باید در داشبورد شما به شکل «هزینه هر گفت و گو» دیده شود تا رشد آن غافلگیرکننده نباشد.
سنجش: چطور بفهمیم ربات هوش مصنوعی NLP بهتر شده
بدون اندازه گیری، لایه هوش مصنوعی به یک جعبه سیاه تبدیل می شود. سه ابزار ساده کافی است:
- مجموعه آزمون: پنجاه پرسش واقعی از گفت و گوهای گذشته با پاسخ درست تاییدشده. هر تغییر در داده یا دستور سیستم با همین مجموعه سنجیده می شود.
- بازبینی هفتگی نمونه ها: هر هفته چند گفت و گو به صورت تصادفی بررسی شود و پاسخ های نادرست برچسب بخورند.
- شاخص های عملیاتی: درصد پاسخ درست در مجموعه آزمون، درصد انتقال به اپراتور، و نسبت پاسخ های «نمی دانم» به کل گفت و گوها.
این سه ابزار، تفاوت پروژه حرفه ای و پروژه آزمایشی است. اگر می خواهید همین سنجه ها در چارچوب بزرگ تر کسب و کار شما بنشیند، شاخص های موفقیت پروژه ربات و اتوماسیون را ببینید.
چه چیزهایی را به مدل نسپاریم
سه حوزه را باید از اختیار مدل بیرون نگه دارید: تعهد مالی (قیمت نهایی، تخفیف، شرایط پرداخت)، تعهد حقوقی یا پزشکی، و تغییر وضعیت واقعی در سیستم ها. مدل می تواند پیشنهاد بدهد و متن بنویسد، اما اجرای تغییر باید با قواعد مشخص یا تأیید انسانی انجام شود.
منطق درست این است: مدل، لایه فهم و نگارش باشد؛ لایه اجرا با کدی باشد که قابل آزمون و حسابرسی است. همین جداسازی، در پروژه های سازمانی با اتوماسیون فرآیندهای کسب و کار (RPA) گره می خورد: مدل داده را می فهمد و لایه اجرا، آن را در سیستم ثبت می کند.
یک تجربه مهندسی که ارزش تکرار دارد: بازیابی به تنهایی کافی نیست و کیفیت داده تعیین کننده است؛ به همین دلیل پروژه هایی که منابع متناقض دارند، بعد از افزودن مدل هم پاسخ قابل اعتماد نمی دهند و باید ابتدا دامنه پاسخ ها را از یکپارچه سازی API اتوماسیون تغذیه کنند.
مسیر اجرای پنج گامی
- دامنه پرسش ها را از داده واقعی بیرون بکشید: سی پرسش پرتکرار و پاسخ درست تاییدشده.
- پایگاه دانش را از منابع رسمی بسازید و نسخه قدیمی محتوا را حذف کنید.
- با همین سی پرسش، نسخه اول را بسازید و درصد پاسخ درست را اندازه بگیرید.
- مسیر انتقال به انسان و پیام «نمی دانم» را از روز اول فعال کنید.
- بعد از دو هفته اجرا، از لاگ واقعی پرسش اضافه کنید و چرخه را تکرار کنید.
برای اتصال منظم این لایه به سیستم های داخلی مانند CRM و انبار، یکپارچه سازی API نقشه راه کاملی دارد.
ما لایه هوشمند را جدا از ربات نمی فروشیم؛ آن را روی همان ربات و پایگاه دانش شما می نشانیم، مسیر انتقال به انسان را فعال می کنیم و ماهانه درصد پاسخ درست را با شما مرور می کنیم. سرویس های اتصال ربات به هوش مصنوعی در بخش سرویس های ربات و اتوماسیون و مراحل اجرایی در بخش فرآیند اجرای پروژه آمده است.
ربات هوش مصنوعی از کجا پاسخ می دهد و چطور پاسخ اشتباه نمی دهد؟
پاسخ از پایگاه دانش خود شما می آید: پرسش کاربر به بردار تبدیل می شود، مرتبط ترین بخش های اسناد پیدا می شود و مدل فقط بر پایه همان بخش ها پاسخ می نویسد. این روش خطای پاسخ ساختگی را به شکل محسوس کم می کند، اما صفر نمی شود. برای کنترل بهتر، باید کیفیت اسناد را بالا ببرید، به مدل اجازه «نمی دانم» بدهید و برای اطلاعات حساس مثل قیمت، یک لایه بازبینی بگذارید.
برای اتصال ربات به هوش مصنوعی به چه چیزهایی نیاز داریم؟
چهار ورودی لازم است: پایگاه دانش پاکسازی شده از منابع رسمی خودتان، فهرست پرسش های پرتکرار با پاسخ تاییدشده، دسترسی به یک مدل زبانی (هر مدلی که با دامنه و بودجه شما همخوان باشد) و یک کانال ارتباطی مثل ربات پیام رسان. علاوه بر این ها، باید مسیر انتقال به اپراتور انسانی و روش ثبت لاگ گفت و گوها هم از ابتدا مشخص باشد.
هزینه ماهانه هوش مصنوعی ربات چطور محاسبه می شود؟
بر پایه حجم متن ورودی و خروجی محاسبه می شود؛ یعنی هر چه پاسخ ها طولانی تر و پرسش ها بیشتر باشد، هزینه بالاتر می رود. سه اقدام هزینه را پایین می آورد: دسته بندی پرسش ها با مدل کوچک و ارزان، محدود کردن حافظه گفت و گو به چند پیام آخر و ذخیره پاسخ های پرتکرار. برای پیش بینی درست، میانگین طول پرسش و درصد پرسش های نیازمند پاسخ مولد را در حجم واقعی بسنجید.
آیا هوش مصنوعی جای کارشناسان پشتیبانی را می گیرد؟
در پروژه های واقعی، نقش کارشناس تغییر می کند نه اینکه حذف شود. ربات پرسش های تکراری و ساده را پاسخ می دهد و کارشناس روی موارد پیچیده، مشتری ناراضی و تصمیم هایی که نیاز به اختیار دارند متمرکز می شود. اگر ربات را به عنوان جایگزین کامل انسان طراحی کنید، هم ریسک پاسخ اشتباه بالا می رود و هم تجربه مشتری در موارد دشوار آسیب می بیند. مدل درست، همکاری با انتقال کنترل شده است.
چطور بفهمیم ربات هوشمند ما بهتر شده است؟
با یک مجموعه آزمون ثابت از پرسش های واقعی و پاسخ های تاییدشده. هر تغییر در داده یا دستور سیستم را با همان مجموعه بسنجید و درصد پاسخ درست را قبل و بعد مقایسه کنید. کنار آن، درصد انتقال به اپراتور و درصد پاسخ های «نمی دانم» را پایش کنید. بازبینی هفتگی چند گفت و گوی تصادفی هم لازم است، چون بعضی خطاها فقط در گفت و گوی واقعی خودشان را نشان می دهند.
جمع بندی
اتصال ربات به هوش مصنوعی، پروژه ای است که با داده شروع می شود نه با مدل. سه کار را اول انجام بدهید: پرسش های واقعی را استخراج کنید، پایگاه دانش را پاکسازی کنید و مسیر «نمی دانم» را فعال کنید. سپس هزینه را با مسیرسازی و ذخیره پاسخ کنترل کنید و پیشرفت را با مجموعه آزمون بسنجید. اگر می خواهید بدانید لایه هوشمند برای کسب و کار شما ارزش اقتصادی دارد یا نه، با کارشناسان ما صحبت کنید تا روی حجم واقعی پرسش های خودتان محاسبه شود.

 افزودن به منابع ترجیحی گوگل