خلاصه در یک نگاه
- فارسی به دلیل نیم فاصله ناپایدار، صرف پیچیده افعال و کمبود داده برچسب خورده، یکی از دشوارترین زبان ها برای پردازش زبان طبیعی محسوب می شود.
- ابزارهایی مثل هضم و پارسیوار و مدل هایی مثل ParsBERT، FaBERT و PersianMind در چند سال اخیر بخش زیادی از این شکاف را پر کرده اند.
- چت بات فارسی، تحلیل احساسات نظرات مشتریان و تبدیل گفتار به متن، پرتقاضاترین کاربردهای NLP در کسب و کارهای ایرانی هستند.
- موفقیت یک پروژه NLP فارسی بیشتر به کیفیت داده و بازبینی انسانی وابسته است تا صرفا انتخاب مدل.
- بازار جهانی NLP در سال 2026 ده ها میلیارد دلار برآورد می شود و با رشد دورقمی سالانه پیش می رود؛ سهم زبان فارسی از این فناوری هنوز جای رشد زیادی دارد.
اگر تا به حال از یک چت بات فارسی سوالی پرسیده اید و جواب عجیب و بی ربطی گرفته اید، تنها کسی نیستید که این تجربه را داشته است. پردازش زبان طبیعی یا NLP در زبان هایی مثل انگلیسی سال هاست به بلوغ رسیده، اما فارسی داستان متفاوتی دارد؛ نیم فاصله های نامرتب، افعال پیچیده و کمبود متن برچسب خورده باعث شده اند مدل های عمومی، فارسی را کمی دست و پا شکسته بفهمند. خبر خوب این است که هم ابزارهای متن باز فارسی و هم مدل های زبانی اختصاصی، این فاصله را به شکل چشمگیری کم کرده اند. در ادامه می بینیم چالش های واقعی NLP فارسی چیست، چه راهکارهایی آن ها را حل می کنند و یک کسب و کار ایرانی چطور می تواند از آن برای چت بات، تحلیل احساسات مشتریان یا اتوماسیون محتوا استفاده کند.
پردازش زبان فارسی؛ چرا هوش مصنوعی اینجا مسیر سخت تری دارد؟
پردازش زبان طبیعی شاخه ای از هوش مصنوعی است که به رایانه اجازه می دهد متن و گفتار انسانی را بفهمد، تحلیل کند و تولید کند؛ از تشخیص احساس یک نظر مشتری تا پاسخ دادن یک دستیار هوشمند به یک سوال ساده. مشکل از جایی شروع می شود که بیشتر پیشرفت های این حوزه، روی زبان هایی مثل انگلیسی و چینی اتفاق افتاده که میلیاردها سند برچسب خورده در اختیار پژوهشگران گذاشته اند. فارسی با وجود بیش از صد و ده میلیون گویشور در ایران، افغانستان، تاجیکستان و چند کشور دیگر، همچنان زبانی کم منبع یا Low Resource طبقه بندی می شود؛ یعنی داده و ابزار استاندارد کافی نسبت به حجم گویشورانش وجود ندارد. مرورهای دانشگاهی جامع روی صدها مقاله علمی درباره فارسی هم همین را تایید می کنند و نشان می دهند مدل های زبانی حتی در وظایف نسبتا ساده مثل پرسش و پاسخ، هنوز در درک عمیق معنایی فارسی با چالش روبه رو هستند.
نیم فاصله، صرف پیچیده و کمبود داده؛ سه مانع اصلی NLP فارسی
وقتی متخصصان NLP درباره سختی فارسی صحبت می کنند، معمولا به سه دسته مانع فنی اشاره می کنند که هرکدام به شکل خودشان سر راه مدل ها سبز می شوند.
نیم فاصله؛ جزئی کوچک که مدل ها را گیج می کند
در فارسی رسمی، کلمه ای مثل کتاب ها باید با نیم فاصله نوشته شود، اما در عمل همان کلمه گاهی سرهم، گاهی با فاصله کامل و گاهی با نیم فاصله نوشته می شود؛ یک واژه واحد می تواند سه شکل نوشتاری متفاوت داشته باشد. توسعه دهندگان کتابخانه های فارسی می گویند بخش بزرگی از فرایند نرمال سازی متن، صرف یکدست کردن همین ناهماهنگی می شود، چون اگر مدل یک کلمه را در سه شکل مختلف ببیند، آن را سه واژه جدا در نظر می گیرد، نه یک مفهوم. همین چالش در سیستم های تشخیص نویسه یا OCR هم دیده می شود؛ پژوهش های تشخیص متن فارسی در تصویر، درست خواندن فاصله و نیم فاصله را یکی از سخت ترین بخش های کار توصیف کرده اند. اگر می خواهید بدانید هوش مصنوعی چطور تصویر و متن فارسی اسکن شده را می خواند، مقاله بینایی ماشین و پردازش تصویر در کسب و کار این موضوع را کامل تر توضیح داده است.
صرف افعال و ساختار نحوی پیچیده
فارسی از نظر صرف فعل و ساخت واژه، زبانی نسبتا پیچیده است؛ یک فعل می تواند بسته به زمان، شخص، وجه و پیشوند، ده ها شکل مختلف به خود بگیرد. پژوهش های تحلیل احساسات فارسی دقیقا همین نکته را یکی از موانع اصلی می دانند و تاکید می کنند بسیاری از تکنیک های بردار کلمه که برای انگلیسی طراحی شده اند، برای فارسی بهینه نیستند و باید با داده فارسی دوباره آموزش ببینند.
کمبود پیکره برچسب خورده و تنوع گویش ها
برای آموزش یک مدل دقیق، به هزاران یا میلیون ها نمونه متن برچسب خورده نیاز است؛ متنی که از قبل مشخص شده مثبت است یا منفی، اسم است یا فعل. برای فارسی چنین مجموعه های بزرگ و باکیفیتی به اندازه انگلیسی وجود ندارد؛ و وقتی خانواده زبان های ایرانی مثل کردی، بلوچی، گیلکی و مازندرانی را هم در نظر بگیریم که کم منبع تر از فارسی استاندارد هستند، و حتی فارسی در ایران، افغانستان و تاجیکستان هم از نظر رسم الخط و واژگان تفاوت دارد، ساخت یک مدل واحد که همه این گونه ها را خوب بفهمد دشوارتر می شود.
از هضم تا FaBERT؛ مسیر تکاملی ابزارهای پردازش متن فارسی
خبر خوب این است که جامعه توسعه دهندگان فارسی زبان، تنبل ننشسته و مسیر تکامل ابزارهای NLP فارسی را می توان در سه نسل خلاصه کرد. نسل اول، کتابخانه های قاعده محور و آماری مثل هضم است که از حدود سال 1392 در دانشگاه علم و صنعت توسعه داده شد و کارهایی مثل نرمال سازی، جداسازی جمله و کلمه و ریشه یابی را انجام می دهد؛ پارسیوار هم در همین دسته قرار می گیرد و برای تحلیل های دقیق تر زبانی مناسب تر است. نسل دوم، مدل های زبانی از پیش آموزش دیده بر پایه ترنسفورمر هستند؛ ParsBERT که روی میلیون ها سند فارسی آموزش دیده، نمونه شناخته شده این نسل است و نسخه های جدیدتری مثل FaBERT هم به آن اضافه شده اند. نسل سوم هم مدل های زبانی بزرگ فارسی مثل PersianMind، Dorna و PersianLLaMA هستند که برای تولید متن، پاسخ به پرسش و ساخت دستیار هوشمند به کار می روند و در برخی محک های استاندارد، عملکردی نزدیک به مدل های بزرگ تجاری نشان داده اند.
| نسل ابزار | نمونه ها | کاربرد اصلی | مناسب برای |
|---|---|---|---|
| کتابخانه های پیش پردازش قاعده محور و آماری | هضم، پارسیوار، نغز | نرمال سازی، توکن سازی، ریشه یابی، تشخیص جمله | پروژه های سبک و مرحله پیش پردازش |
| مدل های زبانی از پیش آموزش دیده ترنسفورمری | ParsBERT، FaBERT | طبقه بندی متن، تحلیل احساسات، تشخیص موجودیت | تحلیل حجم بالای متن با دقت بالا |
| مدل های زبانی بزرگ فارسی | PersianMind، Dorna، PersianLLaMA | تولید متن، پاسخ به پرسش، خلاصه سازی، مکالمه | دستیار هوشمند و تولید محتوای فارسی |
| سیستم های بازیابی افزوده روی پایگاه دانش | معماری های PersianRAG | پاسخ دقیق بر اساس اسناد داخلی سازمان | پشتیبانی مشتری و پایگاه دانش سازمانی |
NLP فارسی در عمل؛ کجای کسب و کار شما همین حالا می تواند از آن سود ببرد؟
خیلی از کسب و کارهای ایرانی بدون اینکه اسمش را بگذارند NLP، همین حالا به آن نیاز دارند. چند نمونه رایج را مرور می کنیم.
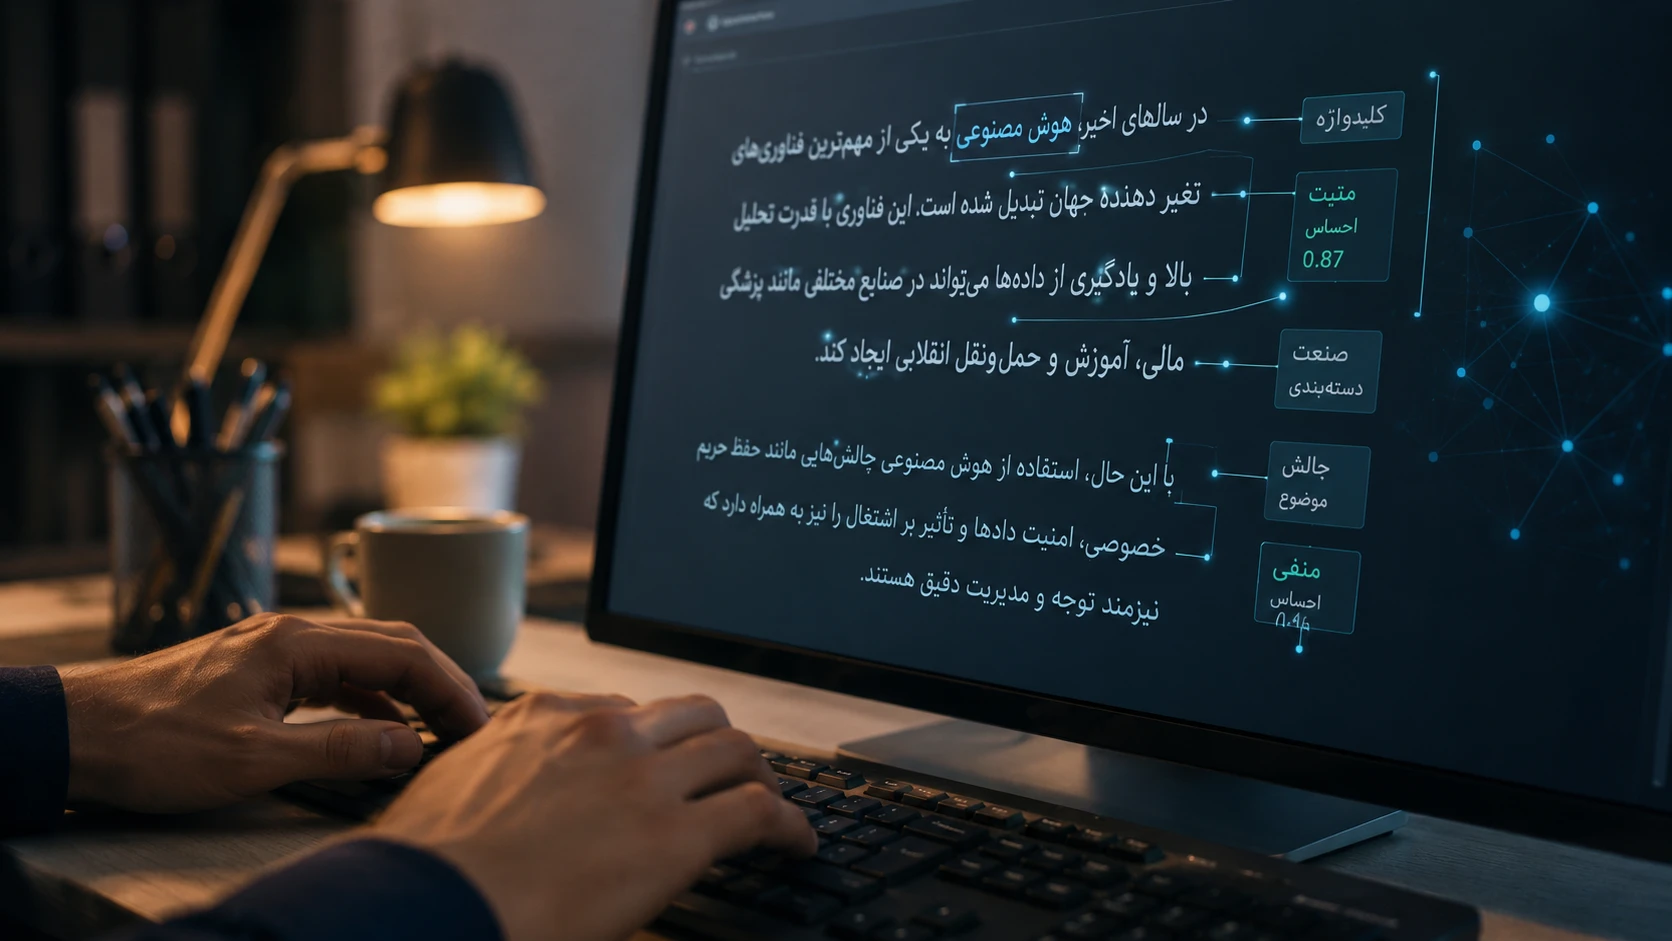
تحلیل احساسات نظرات مشتریان. شرکت هایی که روی سوشال لیسنینگ و تحلیل بازخورد کار می کنند، از NLP برای دسته بندی خودکار نظرات کاربران به مثبت، منفی و خنثی استفاده می کنند؛ این تحلیل می تواند حجم زیادی از نظرات شبکه های اجتماعی و فروشگاه های آنلاین را در زمان کوتاه پردازش و الگوهای تکرارشونده نارضایتی مشتری را زودتر آشکار کند.
تحلیل مکالمات مرکز تماس. برخی سیستم های تحلیل احساسات فارسی، علاوه بر متن پیاده شده تماس، لحن صدای مشتری را هم بررسی می کنند تا مشخص شود در کدام مرحله، مثل احراز هویت یا توضیح هزینه ها، بیشترین نارضایتی شکل می گیرد؛ این بینش برای بهبود فرایند پشتیبانی ارزشمند است.
تبدیل گفتار به متن. ابزارهای فارسی تبدیل صوت به متن، امکان پیاده سازی خودکار تماس های پشتیبانی و جلسات را فراهم کرده اند؛ گرچه تشخیص دقیق احساس از روی صدا هنوز یک حوزه تحقیقاتی فعال است.
استخراج اطلاعات از اسناد و فرم های فارسی. ترکیب OCR برای خواندن تصویر سند و NLP برای فهمیدن محتوای آن، به کسب و کارها اجازه می دهد فاکتور، قرارداد یا فرم دستی فارسی را به داده قابل جستجو تبدیل کنند.
تولید و بازنویسی محتوای فارسی. مدل های زبانی بزرگ فارسی برای پیش نویس محتوای تبلیغاتی، خلاصه سازی گزارش یا پاسخ اولیه به سوالات متداول هم به کار می روند؛ این کاربرد را در راهنمای اختصاصی هوش مصنوعی مولد Generative AI ، با جزئیات بیشتری بررسی می کنیم.
چگونه یک پروژه NLP فارسی موفق برای کسب و کار خود طراحی کنید؟
موفقیت یک پروژه NLP فارسی معمولا کمتر به انتخاب مدل مد روز و بیشتر به رعایت چند اصل ساده وابسته است.
یک: کاربرد مشخص را هدف بگیرید، نه هوش مصنوعی به طور کلی. به جای اینکه بگویید می خواهیم از هوش مصنوعی استفاده کنیم، بگویید می خواهیم نظرات فرم رضایت مشتری را خودکار دسته بندی کنیم یا می خواهیم چت بات پشتیبانی سطح اول را بسازیم. هدف مشخص، انتخاب ابزار و داده مورد نیاز را هم مشخص می کند.
دو: روی داده واقعی خودتان سرمایه گذاری کنید. مدل های آماده مثل ParsBERT یا مدل های زبانی بزرگ فارسی نقطه شروع خوبی هستند، اما دقت واقعی زمانی به دست می آید که این مدل ها با نمونه های واقعی از زبان مشتریان شما، نه زبان کتابی، تنظیم دقیق یا Fine tune شوند.
سه: بین مدل آماده و راهکار اختصاصی درست انتخاب کنید. برای حجم داده کم یا نیاز فوری، استفاده از یک سرویس آماده منطقی تر است؛ برای داده حساس یا حجم بالا و تکرارشونده، سرمایه گذاری روی یک مدل اختصاصی معمولا در بلندمدت به صرفه تر تمام می شود.
چهار: بازبینی انسانی را از حلقه حذف نکنید. حتی دقیق ترین مدل های فارسی هم گاهی جمله های مبهم یا طعنه آمیز را اشتباه تفسیر می کنند؛ ترکیب تحلیل ماشینی با بازبینی انسانی دوره ای، تصویر واقعی تری از داده به دست می دهد و از تصمیم گیری اشتباه بر اساس یک خروجی نادرست جلوگیری می کند.
در باگ باز، پیش از هر پیاده سازی NLP فارسی، عملکرد مدل روی نمونه واقعی از داده کسب و کار شما اعتبارسنجی می شود و حریم خصوصی اطلاعات مشتریان در تمام مراحل پروژه رعایت می گردد.
بسته به حجم داده، نوع کاربرد و سطح دقت مورد نیاز، خدمات پردازش زبان طبیعی فارسی باگ باز از پکیج های پایه تا راهکارهای اختصاصی و پیشرفته طراحی شده اند؛ برای دیدن جزئیات پلن ها می توانید سراغ بخش قیمت گذاری صفحه خدمات هوش مصنوعی بروید. اگر هم می خواهید مجموعه کامل خدمات هوش مصنوعی باگ باز شامل NLP، چت بات و اتوماسیون را از نزدیک ببینید، صفحه خدمات هوش مصنوعی باگ باز نقطه شروع خوبی است.
جمع بندی
پردازش زبان طبیعی فارسی دیگر یک حوزه صرفا آزمایشگاهی نیست؛ نیم فاصله و صرف پیچیده هنوز چالش واقعی هستند، اما ابزارهایی مثل هضم، پارسیوار، ParsBERT و مدل های زبانی بزرگ فارسی، فاصله میان فارسی و زبان های پرمنبع را هر سال کمتر می کنند. برای یک کسب و کار ایرانی، نقطه شروع خوب این نیست که منتظر کامل شدن فناوری بماند، بلکه پیدا کردن یک کاربرد مشخص، مثل تحلیل نظرات مشتریان یا یک چت بات پشتیبانی ساده، و شروع با داده واقعی خودش است.
پردازش زبان طبیعی فارسی با انگلیسی چه تفاوت اصلی دارد؟
تفاوت اصلی در حجم داده و ساختار زبان است. انگلیسی سال هاست میلیاردها سند برچسب خورده در اختیار پژوهشگران قرار داده، اما فارسی همچنان زبانی کم منبع محسوب می شود. از طرف دیگر، نیم فاصله ناپایدار، صرف پیچیده افعال و نبود حرکت گذاری در نوشتار عادی، فارسی را از نظر فنی برای مدل های زبانی سخت تر از انگلیسی می کند و نیاز به ابزار و پیش پردازش اختصاصی دارد.
آیا مدل های هوش مصنوعی عمومی مثل ChatGPT برای فارسی خوب کار می کنند؟
در مکالمه های روزمره و ساده، مدل های عمومی معمولا عملکرد قابل قبولی دارند، اما در وظایف تخصصی مثل تحلیل احساسات دقیق، استخراج اطلاعات از اسناد رسمی یا پاسخ دقیق بر اساس دانش داخلی یک سازمان، همچنان افت دقت محسوسی نسبت به انگلیسی دیده می شود. برای این موارد معمولا ترکیب مدل عمومی با داده و پیش پردازش اختصاصی فارسی نتیجه بهتری می دهد.
برای شروع یک پروژه NLP فارسی در کسب و کار چقدر داده نیاز است؟
حجم دقیق به نوع کاربرد بستگی دارد، اما معمولا برای یک نمونه اولیه قابل ارزیابی، چند صد تا چند هزار نمونه متن واقعی از همان حوزه کسب و کار کافی است. نکته مهم تر از حجم، کیفیت و تنوع داده است؛ داده ای که واقعا زبان مشتریان شما را نشان دهد، حتی با حجم کمتر، از یک مجموعه بزرگ اما نامرتبط نتیجه بهتری می دهد.
هزینه پیاده سازی NLP فارسی برای یک کسب و کار متوسط چقدر است؟
هزینه به عواملی مثل حجم داده، نیاز به fine tune کردن مدل اختصاصی و سطح یکپارچگی با سامانه های فعلی کسب و کار بستگی دارد و معمولا از یک پکیج پایه برای تحلیل ساده متن تا یک راهکار اختصاصی و پیشرفته تر متغیر است. جزئیات پکیج ها و بازه قیمتی را می توانید در بخش قیمت گذاری صفحه خدمات هوش مصنوعی باگ باز ببینید.

 افزودن به منابع ترجیحی گوگل