خلاصه در یک نگاه
- سیستم RAG چیست: معماری هوش مصنوعی که مدل زبانی را به اسناد، فایل ها و پایگاه داده واقعی سازمان شما وصل می کند تا به جای حدس زدن، پاسخ را از دل داده های شما پیدا کند
- چرا مهم است: دقت پاسخ ها را بالا می برد، خطای هوش مصنوعی (هالوسیناسیون) را کاهش می دهد و داده های محرمانه سازمان همچنان زیر کنترل خودتان باقی می ماند
- کاربرد اصلی: دستیار پشتیبانی مشتری، جستجوی هوشمند در اسناد و قراردادها، دستیار داخلی کارمندان و تحلیل سریع پرونده های مالی و حقوقی
- هزینه و زمان: پیاده سازی یک سیستم RAG سازمانی معمولا بین یک تا سه ماه زمان می برد و هزینه آن به حجم داده و سطح یکپارچه سازی بستگی دارد
فرض کنید یک کارمند جدید در شرکت شما استخدام شده و می خواهد بداند آخرین نسخه قرارداد همکاری با یک تامین کننده خاص چه بندهایی دارد. به جای گشتن در ده ها پوشه و فایل ورد، کافی است سوالش را از یک دستیار هوشمند بپرسد و در چند ثانیه جواب دقیق، همراه با ارجاع به همان سند، تحویل بگیرد. این دقیقا همان کاری است که سیستم RAG یا پایگاه دانش هوشمند سازمانی انجام می دهد؛ و در این مقاله قرار است ببینیم این فناوری از کجا می آید، چطور کار می کند و چه زمانی برای کسب و کار شما منطقی است.
اگر تا امروز به فکر افزودن یک چت بات یا دستیار هوشمند برای سایت یا واتساپ کسب و کارتان بوده اید اما نگران بوده اید که پاسخ های آن دقیق و مبتنی بر داده های واقعی شرکت نباشد، RAG دقیقا همان حلقه گمشده است.
سیستم RAG چیست؟
RAG مخفف عبارت Retrieval-Augmented Generation یا «تولید متن تقویت شده با بازیابی اطلاعات» است. این اصطلاح اولین بار در سال ۲۰۲۰ در یک مقاله پژوهشی معرفی شد و امروز به یکی از پرکاربردترین معماری های هوش مصنوعی سازمانی در دنیا تبدیل شده است. به زبان ساده، RAG یک لایه میانی بین مدل زبانی بزرگ (مثل GPT یا Claude) و اسناد سازمان شما است. وقتی کاربر سوالی می پرسد، سیستم اول در پایگاه دانش شما دنبال مرتبط ترین بخش های متن می گردد، سپس همان بخش ها را به همراه سوال اصلی تحویل مدل زبانی می دهد تا پاسخ نهایی را بر اساس داده های واقعی شما تولید کند، نه بر اساس دانش عمومی و از پیش آموزش دیده اش.
تفاوت اصلی با یک چت بات معمولی همین جا نمایان می شود. یک چت بات ساده معمولا بر اساس چند سناریوی از پیش تعریف شده یا دانش عمومی مدل پاسخ می دهد؛ اما سیستم RAG هر بار به منبع اطلاعاتی زنده و به روز سازمان مراجعه می کند. برای مقایسه دقیق تر این دو رویکرد و اینکه کدام یک برای کسب و کار شما مناسب تر است، مقاله تفاوت چت بات ساده و دستیار هوشمند RAG را هم بخوانید.
چرا مدل های زبانی به تنهایی برای سازمان کافی نیستند؟
مدل های زبانی بزرگ روی حجم عظیمی از متون عمومی اینترنت آموزش دیده اند، اما هیچ کدام از آنها اطلاعات محرمانه یا داخلی شرکت شما، مثل آخرین لیست قیمت، رویه های داخلی، یا سوابق مشتریان را نمی شناسند. وقتی از یک مدل عمومی درباره جزئیات کسب و کار خودتان سوال بپرسید، دو اتفاق ممکن است بیفتد؛ یا صادقانه می گوید اطلاعاتی ندارد، یا بدتر، با اعتماد به نفس کامل یک پاسخ نادرست می سازد که به آن هالوسیناسیون یا توهم مدل گفته می شود.
راه حل سنتی برای این مشکل، آموزش دوباره یا فاین تیون کردن مدل با داده های اختصاصی سازمان بود؛ کاری که هم پرهزینه است و هم به محض تغییر یک قیمت یا یک رویه داخلی، باید از نو تکرار شود. سیستم RAG این مشکل را دور می زند: به جای اینکه دانش را داخل وزن های مدل حک کند، هر بار در لحظه پاسخگویی سراغ آخرین نسخه اسناد شما می رود. یعنی همین که یک فایل ورد یا اکسل را در پایگاه دانش به روزرسانی کنید، دستیار هوشمند شما هم بلافاصله به آن دسترسی دارد، بدون هیچ هزینه آموزش مجدد.
سیستم RAG چطور کار می کند؟ اجزای اصلی
یک سیستم RAG سازمانی از چهار جزء اصلی تشکیل شده که هر کدام نقش مشخصی در مسیر پاسخگویی دارند:
- پایگاه دانش (Knowledge Base): مجموعه اسناد سازمان شما شامل فایل های PDF، Word، Excel، صفحات وب داخلی و حتی جداول دیتابیس که قرار است منبع پاسخ ها باشند
- لایه embedding: هر بخش از متن شما به یک بردار عددی چند بعدی تبدیل می شود تا رایانه بتواند شباهت معنایی بین جمله ها را بفهمد، نه فقط شباهت کلمه به کلمه
- پایگاه داده برداری (Vector Database): جایی که این بردارها ذخیره و در کسری از ثانیه جستجو می شوند؛ گزینه های رایج شامل pgvector روی PostgreSQL، Qdrant، Pinecone و Weaviate هستند
- بازیاب و مولد (Retriever و Generator): بازیاب مرتبط ترین قطعات متن را پیدا می کند و مولد، که همان مدل زبانی است، پاسخ نهایی را بر اساس آن قطعات می نویسد
یک نکته فنی مهم که کمتر در مقالات فارسی به آن اشاره می شود، مرحله «تکه بندی» یا chunking است؛ یعنی نحوه تقسیم اسناد بزرگ به بخش های کوچک تر پیش از تبدیل به بردار. اگر این تکه بندی درست انجام نشود، حتی بهترین پایگاه داده برداری هم نمی تواند پاسخ دقیقی برگرداند، چون قطعه بازیابی شده نصفه و ناقص خواهد بود. برای زبان فارسی این موضوع اهمیت بیشتری هم دارد، چون ساختار جمله و نشانه گذاری فارسی با انگلیسی تفاوت دارد و تیم فنی باید از ابزارهای پردازش متن فارسی مثل Hazm در کنار مدل های embedding استفاده کند تا کیفیت بازیابی افت نکند.
تفاوت RAG با فاین تیون کردن مدل؛ کدام برای شما مناسب تر است؟
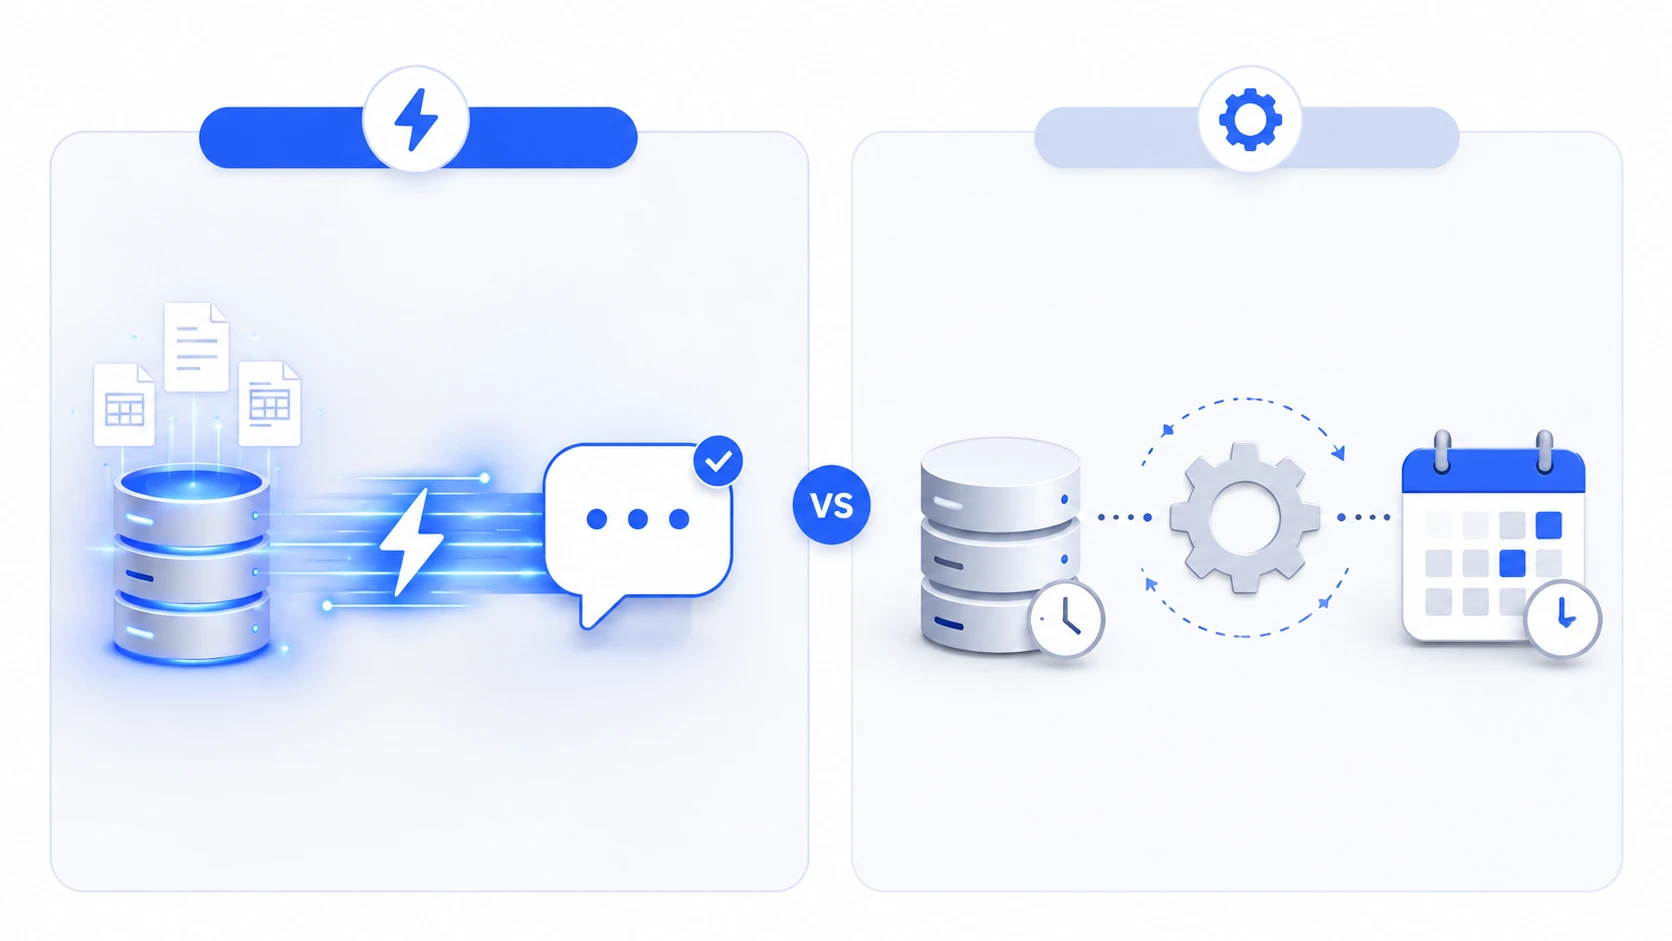
یکی از سوالاتی که تیم های فنی زیاد با آن روبرو می شوند این است که آیا بهتر است مدل را با داده های خودمان فاین تیون کنیم یا سراغ RAG برویم. جواب کوتاه این است که برای اکثر کاربردهای سازمانی، به خصوص وقتی داده ها مدام تغییر می کنند، RAG گزینه منطقی تری است. جدول زیر تفاوت این دو رویکرد را خلاصه می کند.
| معیار | RAG | فاین تیون (Fine-tuning) |
|---|---|---|
| به روزرسانی دانش | آنی؛ فقط کافی است سند جدید را اضافه کنید | نیازمند آموزش دوباره مدل با هر تغییر داده |
| هزینه راه اندازی | پایین تر؛ نیاز به GPU اختصاصی برای آموزش مدل نیست | بالاتر؛ نیازمند منابع محاسباتی سنگین |
| ریسک هالوسیناسیون | کمتر، چون پاسخ به سند واقعی ارجاع دارد | متوسط تا بالا، مخصوصا در داده های کمتر دیده شده |
| مناسب برای | پایگاه دانش پویا، اسناد، قوانین داخلی، پشتیبانی مشتری | یادگیری لحن یا سبک خاص، حوزه های بسیار تخصصی و پایدار |
| قابلیت ارجاع به منبع | دارد؛ می توان سند مرجع پاسخ را نشان داد | ندارد؛ دانش داخل وزن های مدل پنهان است |
در عمل خیلی از پروژه های پیشرفته سازمانی هر دو روش را ترکیب می کنند؛ مدل با فاین تیون سبک، لحن و ساختار پاسخ سازمان را یاد می گیرد و RAG وظیفه تامین دانش به روز و دقیق را بر عهده دارد.
کاربردهای سیستم RAG در کسب و کارهای ایرانی
سیستم RAG یک فناوری انتزاعی و آزمایشگاهی نیست؛ همین امروز در بسیاری از سازمان ها استفاده می شود. چند نمونه کاربرد رایج که در پروژه های واقعی زیاد دیده می شود:
- دستیار پشتیبانی مشتری: پاسخگویی به سوالات فنی و قرارداد محور بر اساس مستندات محصول، نه پاسخ های کلی و غیرقابل استناد
- جستجوی هوشمند در اسناد داخلی: پیدا کردن سریع بندهای خاص از قراردادها، آیین نامه ها یا صورتجلسات بدون نیاز به مرور دستی فایل ها
- دستیار داخلی کارمندان: پاسخ به سوالات رایج درباره فرآیندهای منابع انسانی، رویه های مالی و مستندات فنی تیم های مهندسی
- تحلیل اسناد مالی و حقوقی: استخراج سریع بندهای کلیدی از قراردادها، صورت های مالی یا گزارش های حسابرسی برای تسریع تصمیم گیری
- دستیار فروش: دسترسی سریع تیم فروش به مشخصات فنی، تخفیف ها و شرایط قراردادی بدون نیاز به تماس مکرر با واحدهای دیگر
اگر می خواهید ببینید این کاربردها را می توان چطور در قالب یک دستیار کامل با اتصال به سایت، واتساپ یا تلگرام پیاده سازی کرد، مقاله طراحی چت بات و دستیار هوشمند AI Agent را هم مطالعه کنید.
مزایای پیاده سازی RAG برای سازمان شما
فراتر از دقت پاسخ گویی، RAG چند مزیت عملیاتی مهم برای سازمان دارد که در تصمیم گیری برای سرمایه گذاری روی آن نقش دارند:
- کاهش چشمگیر خطای مدل: چون پاسخ بر اساس سند واقعی ساخته می شود، احتمال تولید اطلاعات نادرست به شدت کاهش پیدا می کند
- حفظ محرمانگی داده ها: اسناد سازمان می توانند روی زیرساخت اختصاصی شما یا سرورهای امن باقی بمانند و لازم نیست دانش داخلی شرکت برای آموزش مدل به بیرون ارسال شود
- صرفه جویی در هزینه نسبت به فاین تیون: بدون نیاز به تکرار فرآیند آموزش پرهزینه مدل با هر تغییر داده
- مقیاس پذیری: با رشد حجم اسناد سازمان، فقط کافی است پایگاه دانش را گسترش دهید، نه کل مدل را از نو بسازید
- قابلیت ارجاع و اعتمادسازی: بسیاری از پیاده سازی های پیشرفته می توانند دقیقا نشان دهند پاسخ از کدام سند و کدام بخش استخراج شده است
مراحل پیاده سازی یک سیستم RAG سازمانی
پیاده سازی RAG یک پروژه چند مرحله ای است که معمولا در قالب زیر پیش می رود:
- جمع آوری و آماده سازی اسناد: شناسایی منابع اطلاعاتی سازمان شامل فایل ها، دیتابیس ها و سیستم های داخلی که باید در پایگاه دانش قرار بگیرند
- تکه بندی و embedding: تقسیم اسناد به بخش های معنادار و تبدیل آنها به بردارهای عددی قابل جستجو
- انتخاب و راه اندازی پایگاه داده برداری: بسته به حجم داده و بودجه پروژه، یکی از گزینه های مدیریت شده یا متن باز انتخاب می شود
- اتصال به مدل زبانی: پیکربندی لایه ای که سوال کاربر، نتایج بازیابی شده و پرامپت نهایی را به مدل زبانی تحویل می دهد
- تست، ارزیابی و بهینه سازی: سنجش دقت پاسخ ها روی سوالات واقعی و اصلاح فرآیند بازیابی تا رسیدن به کیفیت مطلوب
- استقرار و پشتیبانی مستمر: راه اندازی نهایی، آموزش تیم داخلی و برنامه ریزی برای به روزرسانی مداوم پایگاه دانش
هزینه و زمان پیاده سازی RAG چقدر است؟
هزینه یک پروژه RAG به عواملی مثل حجم اسناد، تنوع فرمت فایل ها، نیاز به یکپارچه سازی با CRM یا نرم افزارهای سازمانی و سطح دقت مورد انتظار بستگی دارد. در باگ باز، سیستم های RAG معمولا در قالب دو پلن اصلی زیر ارائه می شوند که جزئیات کامل آنها را می توانید در صفحه تعرفه خدمات هوش مصنوعی ببینید.
مناسب چه کسی است
- شرکت هایی با نیاز به سیستم RAG و پایگاه دانش اختصاصی
- پیاده سازی RAG روی اسناد، فایل ها و دیتابیس سازمان
- اتصال به نرم افزارهای سازمانی موجود
- سه تا شش ماه پشتیبانی فنی
مناسب چه کسی است
- سازمان ها و پروژه های پیچیده با حجم داده بالا
- سیستم RAG به همراه بهینه سازی و مانیتورینگ مستمر
- یکپارچه سازی کامل با زیرساخت سازمان
- شش تا دوازده ماه پشتیبانی فنی
از نظر زمان بندی، پیاده سازی سیستم RAG و پایگاه دانش هوشمند معمولا بین یک تا سه ماه طول می کشد؛ این بازه شامل جمع آوری اسناد، تکه بندی و embedding، راه اندازی پایگاه داده برداری، اتصال به مدل زبانی و دوره تست و بهینه سازی است. پروژه هایی که حجم اسناد بسیار بالا یا نیاز به یکپارچه سازی پیچیده با چند سیستم سازمانی همزمان دارند، طبیعتا به سمت انتهای این بازه نزدیک تر می شوند.
چالش ها و اشتباهات رایج در پیاده سازی RAG
با وجود همه مزایا، پروژه های RAG هم می توانند با چند اشتباه رایج به نتیجه نرسند:
- تکه بندی نادرست اسناد: بریدن متن در جای اشتباه باعث می شود قطعات بازیابی شده ناقص و گمراه کننده باشند
- نادیده گرفتن کیفیت داده منبع: اگر اسناد ورودی قدیمی، تکراری یا متناقض باشند، بهترین پایگاه داده برداری هم نمی تواند پاسخ درستی بسازد
- عدم ارزیابی مستمر: بسیاری از تیم ها بعد از راه اندازی اولیه دیگر دقت پاسخ ها را نمی سنجند و افت کیفیت را دیر متوجه می شوند
- غفلت از کنترل دسترسی: بدون تعریف درست سطح دسترسی، ممکن است اطلاعات محرمانه یک بخش در اختیار کاربرانی قرار بگیرد که نباید به آن دسترسی داشته باشند
امنیت داده در پروژه های RAG یک انتخاب جانبی نیست، بلکه بخشی جدایی ناپذیر از طراحی سیستم است. در پیاده سازی هایی که باگ باز انجام می دهد، اسناد سازمان می توانند روی زیرساخت اختصاصی یا سرور داخلی همان سازمان میزبانی شوند، دسترسی ها به صورت مبتنی بر نقش تعریف می شوند و تمام مسیر ارتباطی رمزنگاری شده است تا داده های محرمانه شما حتی در فرآیند پاسخ گویی هوش مصنوعی هم از کنترل شما خارج نشود.
سیستم RAG چه زمانی برای کسب و کار شما منطقی است؟
اگر سازمان شما حجم قابل توجهی از اسناد، مستندات فنی، سوابق مشتری یا داده های داخلی دارد که مدام در حال به روزرسانی است و کارمندان یا مشتریان زمان زیادی صرف پیدا کردن اطلاعات درست در آن می کنند، RAG یکی از منطقی ترین سرمایه گذاری های هوش مصنوعی برای شما خواهد بود. در مقابل، اگر فقط به دنبال یک پاسخگوی ساده برای چند سوال متداول هستید، شاید یک چت بات ساده تر و کم هزینه تر همان نتیجه را با سرعت بیشتری بدهد. برای سنجش دقیق نیاز کسب و کارتان و اینکه پاسخ های تیم شما چقدر می تواند از تحلیل داده و گزارش گیری هوشمند هم بهره ببرد، مقاله تحلیل داده و هوش تجاری با هوش مصنوعی منبع خوبی برای ادامه مسیر است.
جمع بندی
سیستم RAG راهی مطمئن برای وصل کردن قدرت مدل های زبانی به دانش واقعی و به روز سازمان شماست، بدون هزینه و پیچیدگی آموزش دوباره مدل. از پشتیبانی مشتری گرفته تا جستجوی هوشمند در اسناد داخلی، این فناوری می تواند ساعت ها زمان تیم شما را برای پیدا کردن اطلاعات درست، ذخیره کند و دقت پاسخ های هوش مصنوعی سازمانتان را به شکل محسوسی بالا ببرد. اگر می خواهید ببینید سیستم RAG دقیقا چطور می تواند روی داده های خود شما پیاده شود، تیم خدمات هوش مصنوعی باگ باز آماده بررسی رایگان نیاز کسب و کار شماست.
سیستم RAG چه فرقی با یک چت بات معمولی دارد؟
چت بات معمولی معمولا بر اساس سناریوهای از پیش تعریف شده یا دانش عمومی مدل زبانی پاسخ می دهد. سیستم RAG اما پیش از پاسخ دادن، در پایگاه دانش سازمان شما جستجو می کند و پاسخ را از دل اسناد واقعی شرکت می سازد. همین تفاوت باعث می شود پاسخ های RAG دقیق تر و همیشه به روز باشند، در حالی که چت بات ساده با تغییر اطلاعات سازمان، ممکن است پاسخ قدیمی بدهد.
آیا پیاده سازی RAG برای کسب و کارهای کوچک هم مقرون به صرفه است؟
بستگی به حجم داده و نیاز واقعی کسب و کار دارد. اگر تیم شما مدام در حال جستجو بین اسناد پراکنده است یا حجم سوالات مشتریان درباره جزئیات فنی و قراردادی زیاد است، حتی یک نسخه کوچک از RAG می تواند در زمان و هزینه نیروی انسانی صرفه جویی قابل توجهی ایجاد کند. برای کسب و کارهای بسیار کوچک با حجم اطلاعات محدود، شروع با یک چت بات ساده تر و ارتقا تدریجی به RAG معمولا منطقی تر است.
آیا استفاده از RAG امنیت داده های سازمان را به خطر می اندازد؟
برعکس، یکی از دلایل اصلی محبوبیت RAG در سازمان ها همین کنترل بیشتر روی داده است. چون دانش سازمان داخل وزن های مدل ذخیره نمی شود، اسناد شما می توانند روی زیرساخت اختصاصی یا سرور داخلی خودتان باقی بمانند. با تعریف درست سطح دسترسی و رمزنگاری مسیر ارتباطی، ریسک نشت اطلاعات به شکل چشمگیری کمتر از روش هایی است که داده را برای آموزش مستقیم مدل به بیرون ارسال می کنند.
چه نوع فایل هایی را می توان در پایگاه دانش RAG استفاده کرد؟
سیستم های RAG سازمانی معمولا از انواع فرمت های رایج مثل PDF، Word، Excel، صفحات وب داخلی، ایمیل و حتی جداول دیتابیس پشتیبانی می کنند. نکته مهم این است که هرچه اسناد ورودی تمیزتر، به روزتر و کم تکرارتر باشند، کیفیت پاسخ های نهایی هم بالاتر می رود. به همین دلیل بخشی از هر پروژه RAG حرفه ای، آماده سازی و پاک سازی اولیه همین اسناد است.
پیاده سازی سیستم RAG چقدر طول می کشد؟
برای بیشتر پروژه های سازمانی، بازه زمانی یک تا سه ماه واقع بینانه است. این زمان شامل جمع آوری و آماده سازی اسناد، تکه بندی و ساخت بردارهای معنایی، راه اندازی پایگاه داده برداری، اتصال به مدل زبانی و دوره تست و بهینه سازی می شود. حجم داده، تنوع فرمت فایل ها و میزان یکپارچه سازی با نرم افزارهای سازمانی، مهم ترین عواملی هستند که این بازه زمانی را کوتاه یا بلندتر می کنند.
آیا RAG برای پردازش متن فارسی هم دقت خوبی دارد؟
بله، به شرطی که پیاده سازی به درستی انجام شود. زبان فارسی ساختار جمله بندی و نشانه گذاری متفاوتی نسبت به انگلیسی دارد، بنابراین تیم فنی باید در کنار مدل های embedding از ابزارهای تخصصی پردازش متن فارسی هم استفاده کند تا تکه بندی و بازیابی اطلاعات به درستی انجام شود. با رعایت این نکات فنی، سیستم RAG می تواند دقت بالایی در پاسخ گویی به زبان فارسی داشته باشد.

 افزودن به منابع ترجیحی گوگل